Extraire et structurer les données de documents, l'enrichir, détecter la fraude… Avec l'IA, construire de bout en bout sa solution de traitement de documents ou de détection de fraude n'a jamais paru aussi simple. Cela dit, acheter une solution prête à l'emploi se révèle souvent une meilleure option. Acheter permet de garantir que sa solution utilise les technologies de pointe, gère l'ensemble des erreurs et difficultés techniques que vous rencontrerez inévitablement, gère l'infrastructure pour la montée en puissance, les aspects réglementaires et de sécurité…
Suite à de multiples discussions avec nos prospects et clients confrontés à ces questionnements (construire ou acheter), nous avons réuni la liste complète des trente-neuf difficultés que vous devrez vous attendre à surmonter si vous décidez de construire. Même à l'ère de l'IA où le build est plus facile que jamais, le build reste plus coûteux et difficile qu'il n'y paraît : maintenance, gestion d'erreurs, infrastructure, sécurité… L'IA est certes pleine de promesses, mais aussi pleine d'illusions. Cet article doit vous aider à faire la part des choses.
Construire est devenu rapide
Avant 2025, construire une solution interne de traitement de documents nécessitait une équipe dédiée pendant plusieurs mois. Aujourd'hui, un Claude Code ou autre agent de codage permet de construire un prototype en quelques jours : réception et tri des documents, lecture de PDFs et images, extraction des champs par appel à un modèle de langage, contrôle de cohérence des données et métadonnées, vérification d'authenticité du document, exposition sur une API pour transmission des résultats vers l'ERP ou l'outil métier dans son format, avec une reprise possible en cas d'échec. Sur 100 documents de test, le résultat est bon, et le décideur peut avoir légitimement le sentiment que c'est la solution : construire en interne.
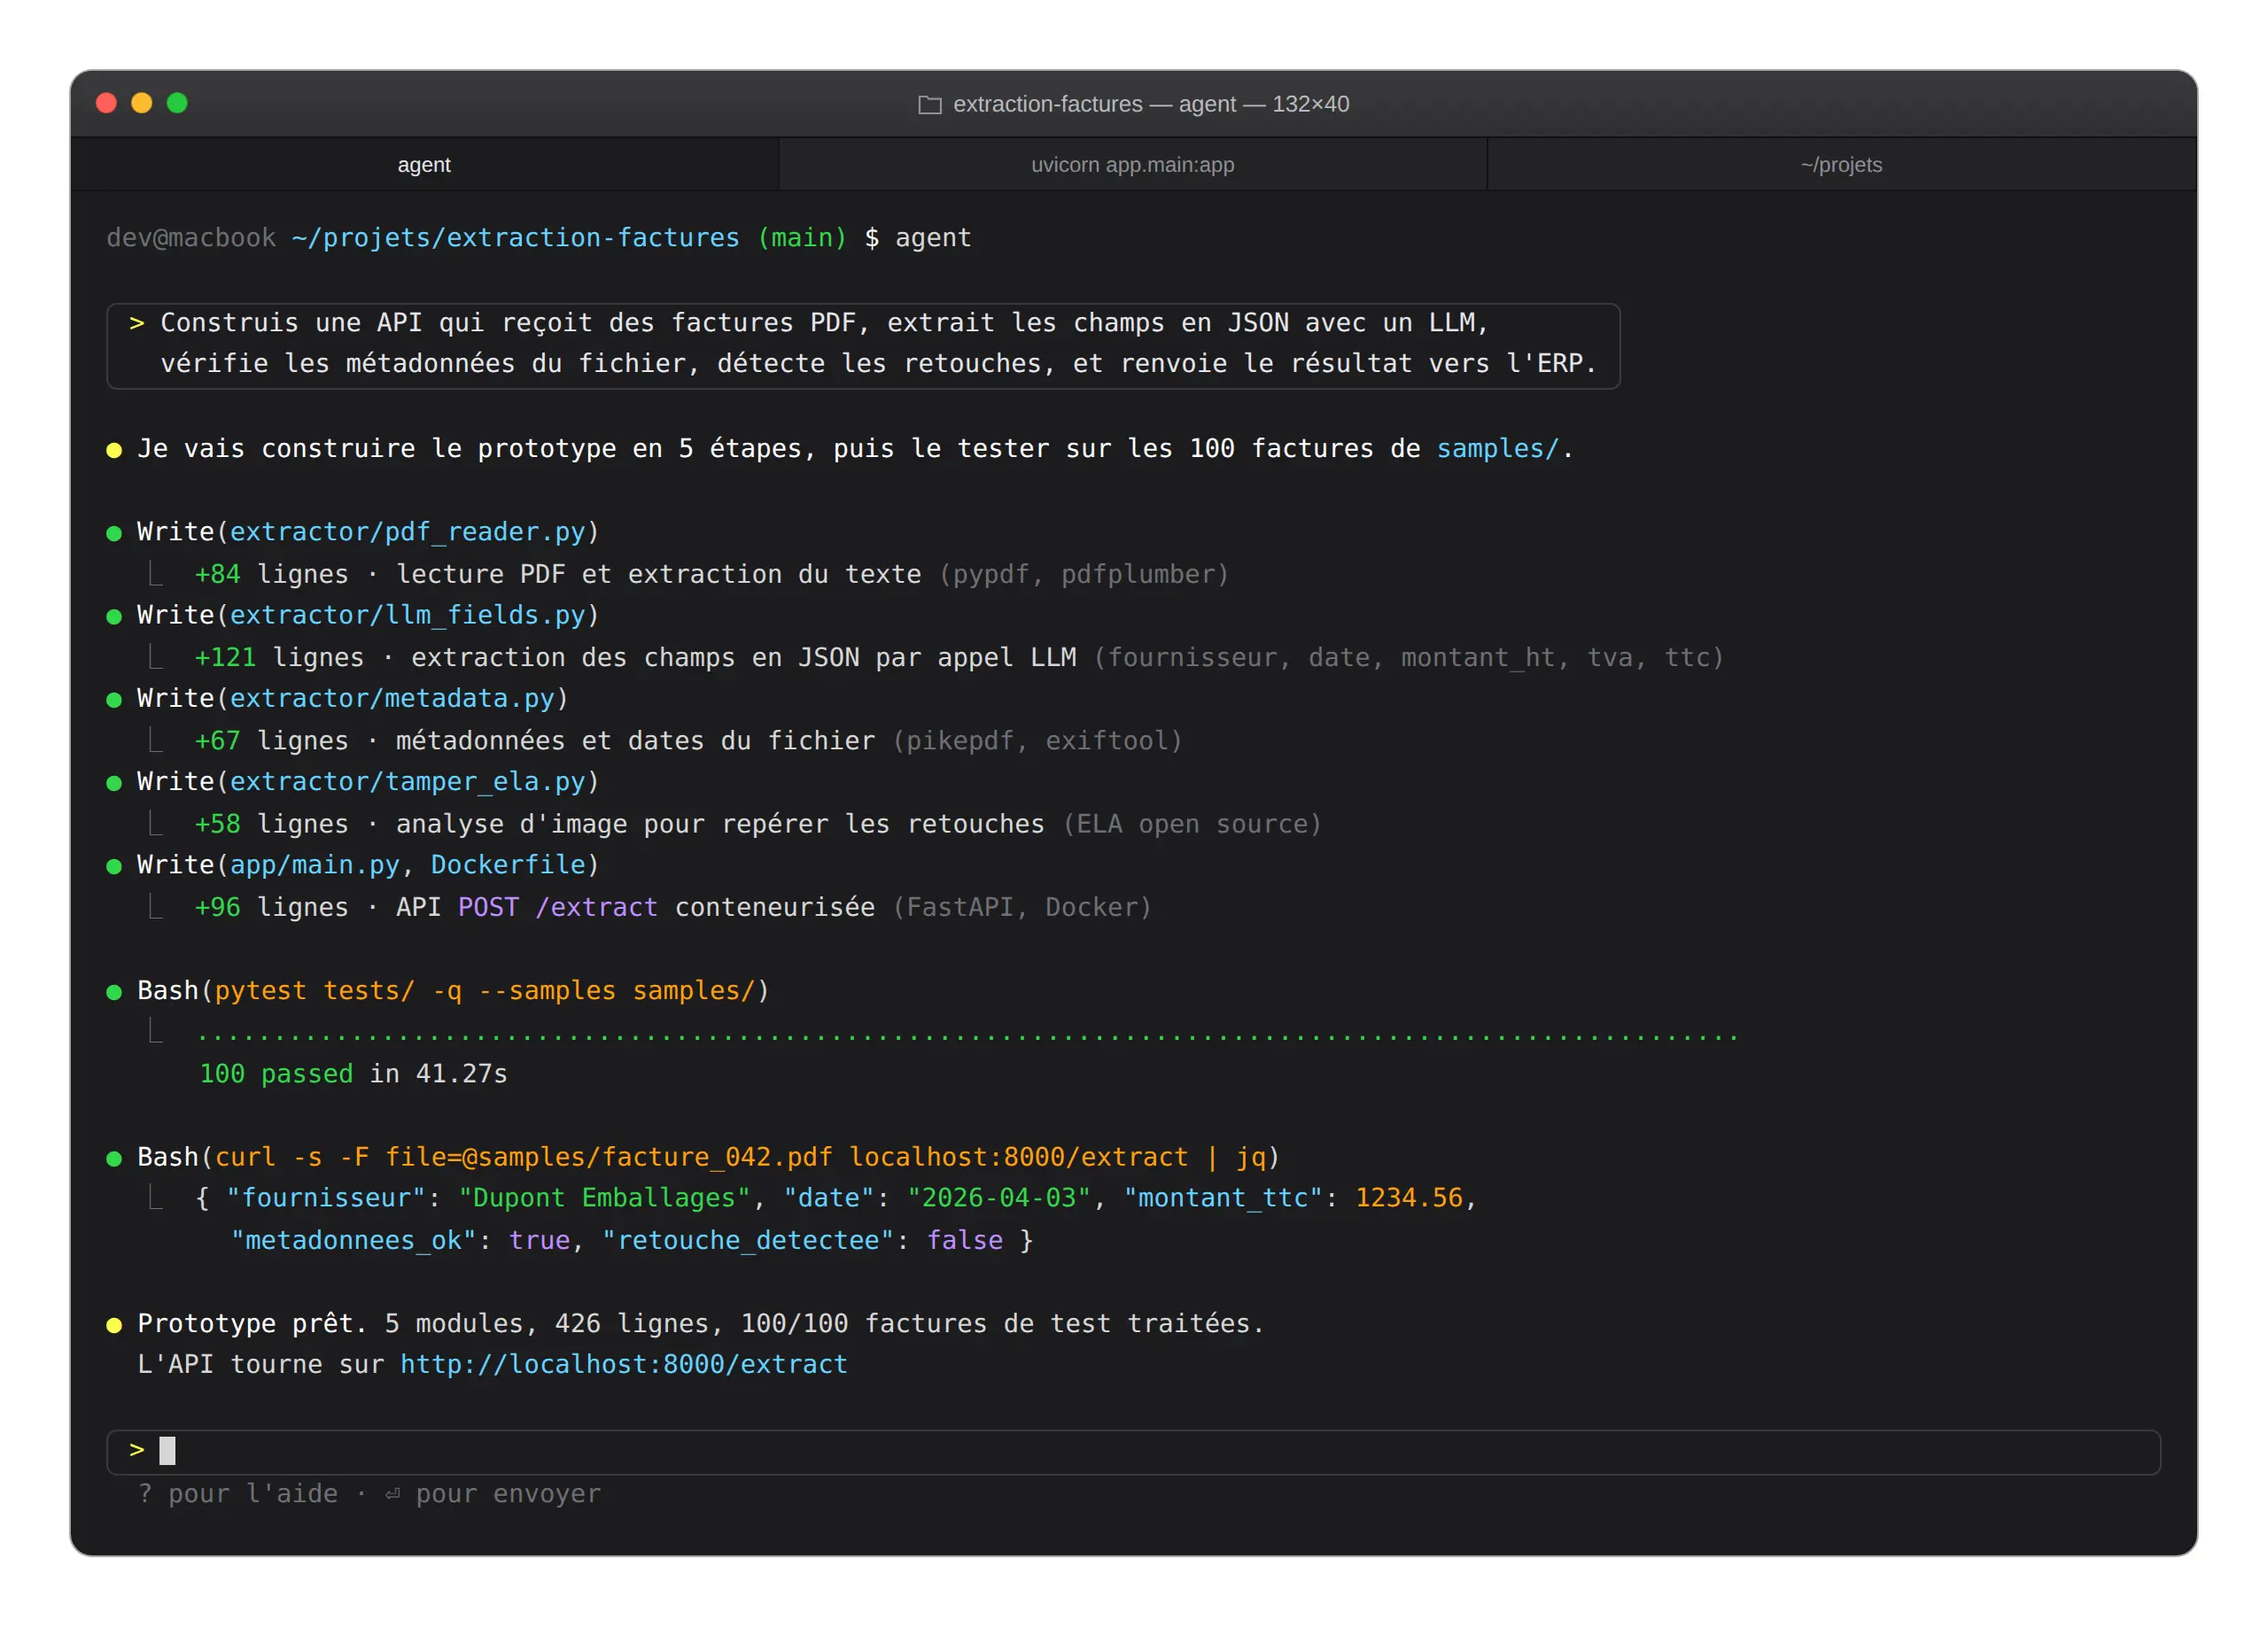
Typiquement, un agent de codage va développer quelque chose peu ou prou de ce type :
La stack fait sens et le code produit est propre, et les outils de ce type ont donc rendu ce prototypage accessible à des équipes restreintes, voire même peu techniques. C'est ce qui est grisant et motivant. C'est ce qui donne le sentiment de pouvoir tout construire en interne. Et c'est aussi ce qui peut constituer un nouveau risque dans la prise de décision.
Trente-neuf difficultés qui apparaissent en production
À la suite de nombreux échanges avec des équipes tentées par le build, nous avons réuni une liste de trente-neuf défis et sujets qui reviennent régulièrement et que vous devrez vous attendre à relever si vous optez pour le build. Aucun défi n'est en soi insurmontable, mais ensemble ils constituent une charge inattendue qu'il vaut mieux avoir anticipée pour ne pas découvrir des bugs en production après quelques semaines. Nous ne comptons plus les fois où un prospect est revenu vers nous quelques mois après avoir tenté de construire, pour finalement acheter. Un temps précieux perdu à cause de l'illusion de facilité que peut procurer l'IA et de la difficulté associée à anticiper dans le détail les défis que l'on va devoir relever.
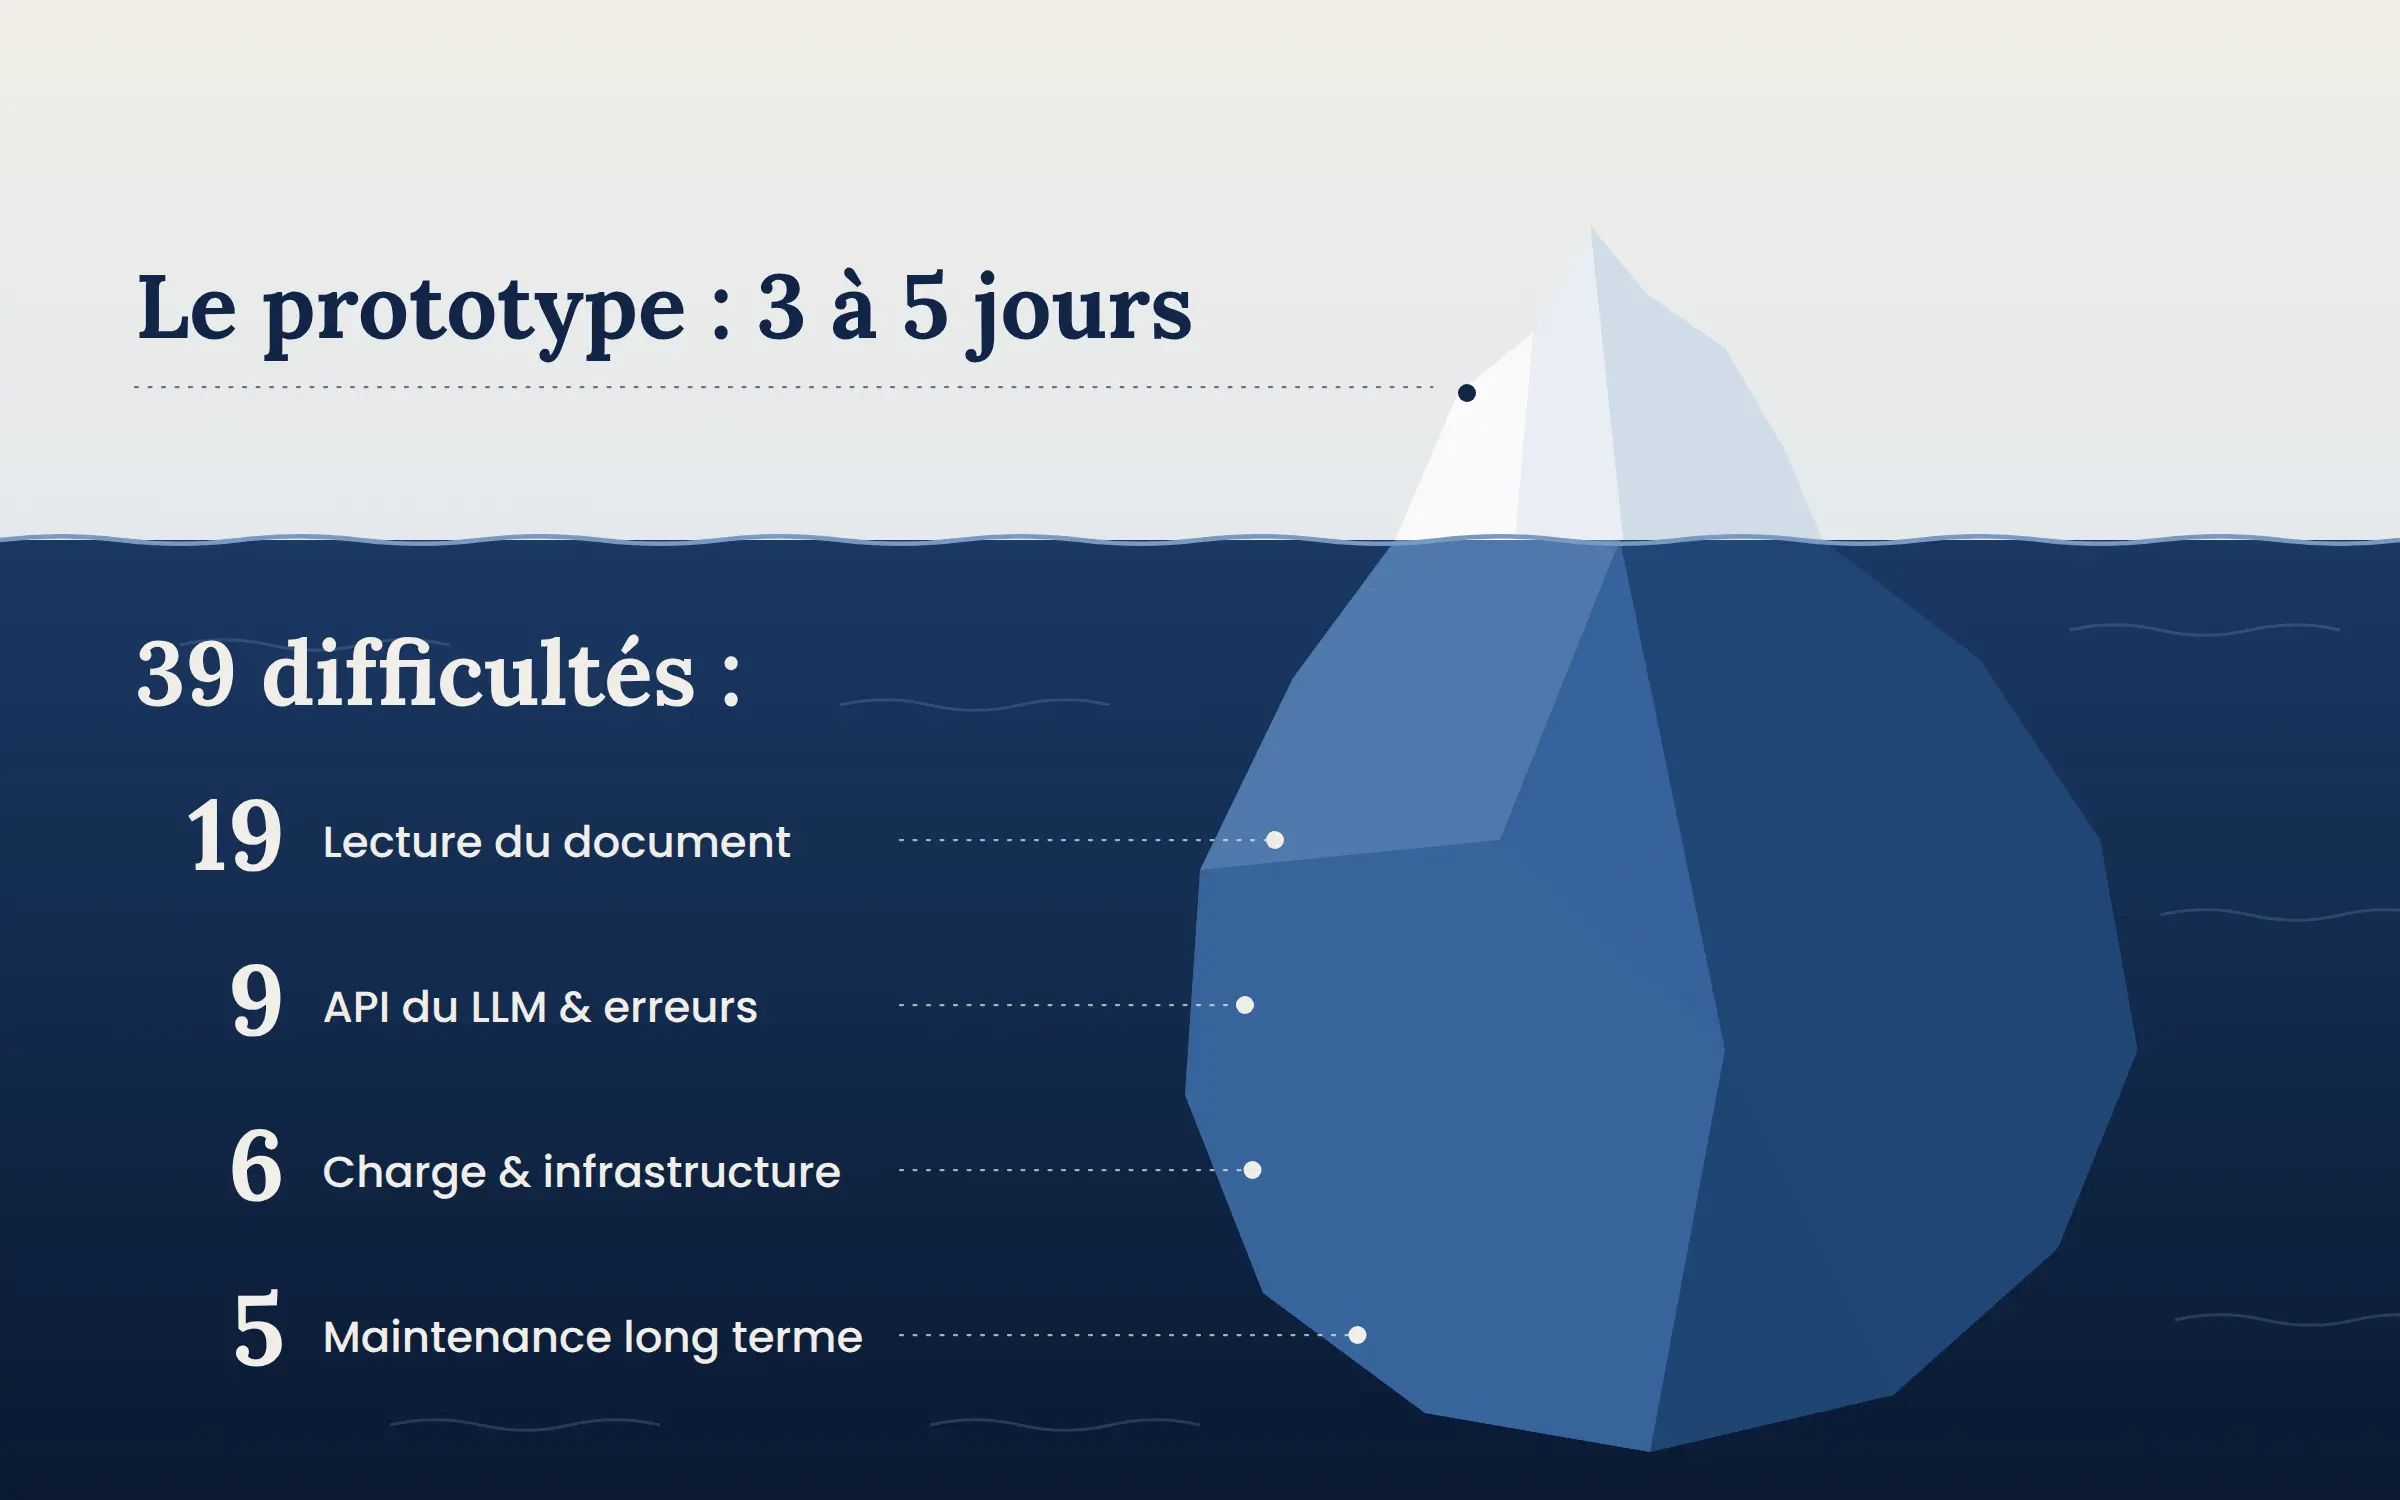
Le découpage d'une liasse de documents et la lecture de l'écriture manuscrite sont deux sujets à part entière. Chacun des autres points est un défi que vous aurez à relever seulement lorsque vous rencontrez l'erreur, en production.
Pris isolément, chacun de ces défis peut se régler en quelques heures. Pris ensemble, ils interagissent et transforment un projet qui se devait rapide et efficace en une usine à gaz coûteuse à développer, maintenir et sécuriser. Autant le savoir avant de se lancer.
La maintenance ne s'arrête jamais
Un outil de traitement de documents s'entretient. Les modèles évoluent tous les quelques mois, les émetteurs changent leurs formats sans prévenir, les exigences de sécurité évoluent, les attentes clients changent. Un projet interne engage donc une charge permanente qui va bien au-delà de la construction initiale.
Cette charge est la moins visible au moment de la prise de décision, et la plus douloureuse. Surtout si elle est découverte après coup. Elle recouvre plusieurs éléments distincts :
- Suivre les modèles disponibles, les évaluer sur ses propres documents, et arbitrer entre qualité, coût et latence.
- Maintenir un jeu de référence annoté, sans lequel aucune amélioration ne se mesure.
- Absorber les changements de format des émetteurs, qui ne préviennent pas.
- Tenir la sécurité et la conformité, souvent devenues une condition pour signer un client.
- Rester disponible pour les incidents, y compris pendant les congés et les périodes chargées.
Ce travail n'a pas de fin. Il occupe durablement une partie d'une équipe, sur un sujet qui n'est presque jamais le métier de l'organisation.
Vérifier que le document est authentique
Les faux documents sont de plus en plus fréquents, et les fraudeurs de plus en plus malins. Comment s'assurer qu'un dossier de demande de prêt ou de dédommagement de sinistre est bien authentique ? Dans ce domaine, le build devient quasiment impossible : analyse d'image et de pixels, étude des métadonnées et centaines de règles métier très spécifiques, comparaison à des bases de données internes de documents de référence, analyse fine de la cohérence du document, comparaison à des données récupérées dans des bases externes.
Un modèle de langage comprend bien qu'il a affaire à un bulletin de paie et en sort le net à payer. Il ne mesure pas les écarts de compression entre deux zones d'une image, il ne compare pas l'outil déclaré dans les métadonnées à ce que produit habituellement un émetteur donné, et il ne repère pas une couche d'objets ajoutée dans le fichier après son émission. Et tout cela doit se faire métier par métier, type de document par type de document, cas d'usage par cas d'usage. Bon courage.
Ce qui manque crucialement aux LLM est la base de comparaison et la connaissance métier fine : savoir ce qu'un émetteur donné produit normalement demande d'avoir observé un grand nombre de ses documents authentiques. Les signaux faibles de la fraude documentaire et les trois méthodes de détection détaillent ce mécanisme.
Quand construire reste la bonne décision
Mais alors, quand construire ? Construire garde du sens dans plusieurs situations. Voici les quatre questions à se poser pour décider :
- D'où viennent les documents ? Produits en interne, le format est maîtrisé et le problème reste sous contrôle. Reçus de tiers, l'hétérogénéité et la sécurité deviennent les sujets critiques.
- Que faut-il en faire après lecture ? S'il s'agit d'alimenter un tableau de bord interne, le risque reste faible. Mais s'il faut déclencher un paiement, accorder un contrat ou refuser un dossier, alors même avec une bonne fiabilité il y a un risque inhérent considérable et difficilement maîtrisable avec une solution maison.
- À quelle fréquence les formats changent-ils ? Un format stable se traite avec un développement ponctuel. Un format qui bouge chaque trimestre suppose que des non-développeurs puissent suivre.
- Le traitement documentaire fait-il partie du métier ? Si c'est le produit vendu, il se construit. Sinon, il entre en concurrence avec le reste de la feuille de route technique.
Le plus court chemin pour se faire une idée consiste à tester sur ses propres documents, en choisissant les plus difficiles plutôt que les plus lisibles.
Dans quels cas construire reste-t-il la bonne décision ?
Quand le document est produit en interne, très structuré et stable, un développement dédié donne de meilleurs résultats qu'un moteur généraliste. Quand le volume est faible et prévisible, sur un format unique, et que la donnée lue ne déclenche pas de décision engageante. Et quand le traitement documentaire fait partie du produit vendu par l'organisation.
Sources
- Observations expertes issues de l'exploitation d'une plateforme de traitement de documents et de détection de fraude : Koncile.