Pendant la majeure partie de la dernière décennie, la réponse à la question « quel OCR open source utiliser » était Tesseract, le reste de la liste n'étant que des notes de bas de page. Ce n'est plus vrai depuis 2025.
Le leader actuel sur OmniDocBench v1.6 est PaddleOCR-VL, avec un score de 96,34 %. Il fonctionne avec 0,9 milliard de paramètres. Qwen3-VL, un modèle vision-langage généraliste doté de 235 milliards de paramètres, obtient 89,78 % sur ce même benchmark. Le modèle le plus petit est 260 fois plus léger et lit mieux les documents.
Ce renversement résume toute l'histoire de l'OCR open source en 2026. Des modèles de petite taille, entraînés spécifiquement sur des documents, surpassent désormais d'énormes modèles généralistes, et devancent les moteurs classiques avec un écart plus important encore. Une liste rédigée il y a dix-huit mois n'est pas légèrement dépassée : elle pointe vers le mauvais segment du marché.
Ce comparatif couvre dix moteurs réellement open source, activement maintenus et utilisables en production. Deux entrées présentes dans la précédente version de cet article ont été retirées ; la raison est expliquée à la fin. Si vous découvrez le sujet, notre guide sur à quoi sert l'OCR et tout ce que vous devez savoir pose d'abord les bases.
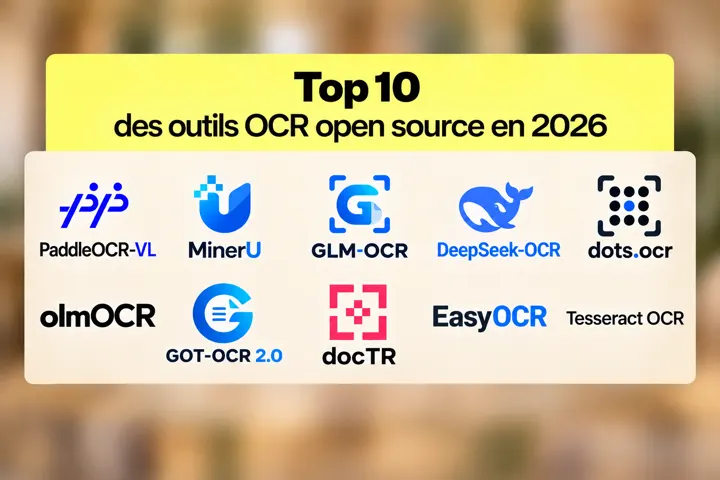
Les 10 meilleurs moteurs OCR open source comparés
Classement basé sur OmniDocBench lorsqu'un score publié existe, complété par les contraintes pratiques qui déterminent généralement le choix : besoin ou non d'un GPU, gestion des tableaux et de l'écriture manuscrite, et ce que la licence autorise.
1. PaddleOCR-VL, le leader actuel en précision
PaddleOCR-VL 1.6 détient le meilleur score publié sur OmniDocBench v1.6, avec 96,34 %, tout en ne comptant que 0,9 milliard de paramètres et en étant distribué sous licence Apache 2.0. C'est cette combinaison qui lui vaut la première place de ce classement.
Il domine simultanément la reconnaissance du texte, des formules et des tableaux, ce qui est rare, et tient bon dans les conditions qui mettent en échec la plupart des moteurs : scans de travers, pages gondolées, photos d'écran et éclairage inégal. Plus de 100 langues sont couvertes. Il convertit également les graphiques en HTML structuré plutôt que de les traiter comme de simples images.
La contrepartie est l'écosystème PaddlePaddle. Si votre stack repose nativement sur PyTorch, attendez-vous à quelques frictions au démarrage. Le modèle est toutefois assez léger pour tourner sur du matériel modeste, ce qui compense en partie cet inconvénient.
Idéal pour : les équipes qui recherchent la meilleure précision généraliste disponible sous licence permissive, et qui peuvent absorber l'apprentissage d'un nouveau framework.
2. MinerU, l'extraction documentaire pensée comme un pipeline
MinerU 2.5-Pro se classe deuxième sur OmniDocBench v1.6 avec 95,75 %, pour 1,2 milliard de paramètres. Il est conçu comme un pipeline d'extraction documentaire plutôt que comme un simple modèle OCR, ce qui signifie qu'il gère aussi le travail périphérique : segmentation du PDF, ordonnancement du flux de lecture et production d'une sortie structurée.
Pour les articles académiques, les rapports et tout document à mise en page complexe multi-colonnes, cette approche en pipeline fait gagner un temps d'ingénierie réel. La sortie est suffisamment propre pour alimenter directement un modèle en aval.
La licence mérite une attention particulière. MinerU est distribué sous AGPL-3.0, et non sous Apache ou MIT. Si vous envisagez de l'exposer via une API interne ou externe, faites-vous conseiller juridiquement avant de vous engager, car la clause de copyleft réseau s'applique.
Idéal pour : la recherche et les pipelines à forte volumétrie documentaire où l'AGPL est acceptable et où la complexité de mise en page constitue le principal défi.
3. GLM-OCR, le meilleur compromis vitesse/précision
GLM-OCR obtient 95,22 % sur OmniDocBench v1.6 avec 0,9 milliard de paramètres, et traite environ 1,86 page par seconde. C'est l'option qui l'emporte le plus souvent sur la combinaison des deux critères, plutôt que sur l'un ou l'autre pris isolément.
Si vous menez un comparatif et ne pouvez tester qu'un seul modèle dans un premier temps, c'est un point de départ défendable : il occupe la tête ou s'en approche sur le benchmark, la licence est permissive, et le débit est suffisant pour être viable en production sans cluster de GPU.
Idéal pour : un premier candidat dans toute évaluation. Un choix par défaut solide en l'absence de contrainte particulière orientant vers une autre option.
4. DeepSeek-OCR, conçu pour le débit
DeepSeek-OCR adopte une approche différente. Sa caractéristique phare est une compression des documents d'environ un facteur dix, ce qui sacrifie un peu de précision au profit de la capacité à traiter de très gros volumes à moindre coût. Il obtient 91,09 % sur OmniDocBench v1.5 et fonctionne à environ 4,65 pages par seconde, avec un débit rapporté proche de 200 000 pages par jour sur un seul GPU A100.
Six modes de résolution permettent d'ajuster le compromis vitesse/précision selon le type de document, ce qui est plus utile qu'il n'y paraît lorsque votre corpus est hétérogène. Il s'agit d'une architecture en mélange d'experts (mixture-of-experts) d'environ 3 milliards de paramètres, dont 570 millions actifs, distribuée sous licence MIT.
Idéal pour : le traitement par lots à haut volume, lorsque le coût par page compte davantage que les deux derniers points de précision.
5. dots.ocr, l'ancrage spatial dans un petit modèle
dots.ocr est un modèle de 1,7 milliard de paramètres sous licence MIT, affiné à partir de Qwen2.5-VL, doté de capacités d'ancrage spatial qui relient le texte extrait à sa position sur la page. Environ 100 langues sont prises en charge, et la sortie est fournie en Markdown ou en JSON.
C'est cet ancrage spatial qui justifie de le choisir. Si votre processus en aval a besoin de savoir où, sur la page, une valeur est apparue, et pas seulement ce qu'elle contenait, la plupart des moteurs vous obligent à reconstruire cette information. Celui-ci la fournit directement.
Idéal pour : les workflows qui ont besoin de coordonnées en plus du texte, comme le caviardage, le surlignage ou les interfaces de relecture humaine.
6. olmOCR, conçu pour l'anglais à grande échelle
olmOCR est développé par l'Allen Institute for AI et distribué sous licence Apache 2.0 ; il est explicitement optimisé pour les pipelines de PDF en anglais à grande échelle plutôt que pour dominer les benchmarks généralistes. Sa variante à 7 milliards de paramètres obtient 81,79 % sur OmniDocBench v1.5.
Ce qui le distingue, c'est son approche d'entraînement, qui repose sur des tests unitaires et de l'apprentissage par renforcement à partir de sorties vérifiables, plutôt que sur un simple fine-tuning supervisé. Sur de longs documents anglais traités en masse, sa fiabilité dépasse ce que laisse penser le score brut. Il nécessite environ 12 Go de VRAM.
Idéal pour : les corpus anglophones volumineux, les pipelines de recherche, et tous les cas où la reproductibilité et la transparence de l'entraînement comptent.
7. GOT-OCR 2.0, le plus petit modèle réellement performant
Avec 580 millions de paramètres sous licence Apache 2.0, GOT-OCR 2.0 est le plus petit moteur de cette liste à encore gérer correctement l'OCR documentaire généraliste. La reconnaissance des formules est un point fort particulier, ce qui compte pour les documents scientifiques et techniques.
La couverture linguistique est plus restreinte, avec une vingtaine de langues : vérifiez que la vôtre en fait partie avant d'y investir du temps. Là où il convient, sa taille le rend déployable dans des environnements inaccessibles aux modèles plus volumineux.
Idéal pour : le déploiement en périphérie (edge), les environnements GPU contraints et les documents techniques riches en formules.
8. docTR, la bibliothèque pour documents structurés
docTR précède la vague des modèles vision-langage et reste utile précisément parce qu'il s'agit d'une bibliothèque et non d'un modèle unique. Il propose des backends TensorFlow et PyTorch, sépare la détection de la reconnaissance afin que vous puissiez remplacer l'une ou l'autre indépendamment, et fonctionne sur CPU si nécessaire.
Pour des documents structurés et prévisibles comme les formulaires ou les factures standardisées, cette architecture en deux étapes offre un niveau de contrôle que les modèles de bout en bout n'offrent pas. Vous pouvez ajuster la détection indépendamment de la reconnaissance, ce qui compte lorsque vos documents se ressemblent tous.
Idéal pour : les équipes Python qui traitent de gros volumes de documents au format homogène et souhaitent garder le contrôle sur chaque étape.
9. EasyOCR, le plus rapide à essayer
EasyOCR prend en charge plus de 80 langues et s'installe en une seule commande pip. Rien d'autre dans cette liste ne permet de passer aussi vite de zéro à du texte extrait, ce qui en fait la bonne première étape pour une preuve de concept, même s'il ne s'agit pas de la bonne réponse finale.
Sa précision sur les mises en page complexes est très en retrait par rapport à la génération actuelle, et la gestion des tableaux est faible. Utilisez-le pour déterminer si l'OCR résout votre problème, puis passez à un moteur plus performant une fois que c'est confirmé.
Idéal pour : les prototypes, les scripts, et tout projet où la rapidité d'intégration prime sur la précision.
10. Tesseract, toujours la seule véritable option CPU
Tesseract est maintenu depuis 2005, prend en charge plus de 100 langues et reste la réponse par défaut dans la plupart des discussions entre développeurs. Sur du texte imprimé propre avec une mise en page simple, il reste parfaitement adapté, et c'est le seul moteur de cette liste à bien fonctionner sans GPU. Ce seul fait le maintient pertinent, quels que soient les scores de benchmark. Nous avons approfondi le sujet dans notre analyse pour savoir si Tesseract est toujours le meilleur OCR open source, avec un benchmark sur des factures réelles.
Ses faiblesses sont bien documentées et n'ont pas changé : les tableaux s'effondrent en texte linéaire, les scans de mauvaise qualité dégradent fortement les résultats, l'écriture manuscrite est pratiquement hors de portée, et le prétraitement fait une bien plus grande partie du travail que ce que la plupart des équipes imaginent.
Idéal pour : les documents imprimés propres, les environnements sans GPU, et tout projet où l'ajout d'une infrastructure GPU n'est pas envisageable.
5 choses que les scores de benchmark ne vous disent pas
OmniDocBench est le signal public le plus utile de cette catégorie, mais il s'agit toujours d'un corpus sélectionné, pas de vos documents. Cinq différences comptent davantage que le classement, et savoir lesquelles s'appliquent à votre cas réduira votre liste plus vite qu'aucun score.
1. Si vous pouvez tout simplement le faire tourner
Six des dix moteurs du tableau sont des modèles vision-langage et nécessitent une inférence GPU, typiquement entre 8 et 16 Go de VRAM. Tesseract fonctionne sur CPU. EasyOCR et docTR tournent aussi sur CPU, mais nettement plus lentement. S'il n'y a pas de GPU dans votre budget, le classement du benchmark devient largement hors sujet, et votre véritable shortlist ne compte que trois entrées.
À vérifier : la fiche du modèle sur Hugging Face indique la VRAM minimale requise. Testez avec votre taille de lot réelle, car la mémoire consommée par page augmente avec la concurrence.
2. Ce qu'il advient des tableaux
Le score global d'OmniDocBench intègre une composante TEDS dédiée aux tableaux ; un bon score global signifie donc généralement de bons résultats sur les tableaux, mais pas toujours. Tesseract aplatit un tableau en texte linéaire et perd totalement les relations entre lignes et colonnes, ce qui est rédhibitoire pour des documents financiers. Notre guide sur la détection et l'extraction de tableaux explique ce que mesure cette métrique et où elle peut induire en erreur.
À vérifier : faites passer l'un de vos pires tableaux par deux moteurs candidats et comparez la structure obtenue, pas seulement la précision au caractère près.
3. Si l'écriture manuscrite est vraiment prise en charge
Chaque éditeur revendique une prise en charge de l'écriture manuscrite, et l'écart entre ces annonces et les résultats réels est plus large ici que partout ailleurs en OCR. L'écriture script soignée fonctionne. Les pages en cursive ou mêlant écriture manuscrite et texte imprimé restent difficiles pour toutes les solutions open source. Nous l'avons testé directement dans notre classement des OCR pour la reconnaissance de l'écriture manuscrite, sur des échantillons réels.
À vérifier : votre pire page manuscrite, pas un échantillon propre. Les écarts entre moteurs ne se révèlent que sur des entrées difficiles.
4. Ce que la licence autorise réellement
Les licences Apache 2.0 et MIT autorisent un usage commercial sans obligation particulière, et couvrent l'essentiel de cette liste. MinerU est distribué sous AGPL-3.0, ce qui déclenche des obligations de copyleft dès que vous l'exposez via un réseau , un piège qui surprend de nombreuses équipes construisant des API internes. Plusieurs projets de ce secteur ont modifié les termes de leur licence au cours de l'année écoulée.
À vérifier : le fichier LICENSE du dépôt, aujourd'hui , pas ce qu'affirmait un article comparatif le trimestre dernier. Celui-ci y compris.
5. Ce qu'il reste encore à construire ensuite
L'OCR vous donne du texte, et pour les meilleurs modèles, la mise en page. Il ne vous dit pas quels champs sont fiables, si les totaux se recoupent, si ce document est un doublon de celui traité la semaine dernière, ou s'il a été falsifié. Les équipes qui traitent des factures en volume le découvrent une fois que l'extraction fonctionne, alors que le workflow, lui, ne fonctionne toujours pas. Le scoring de confiance au niveau des champs et la détection de fraude documentaire sont des problématiques distinctes de la reconnaissance de caractères.
À vérifier : notez précisément ce qu'il advient du texte après extraction. Si la réponse implique de la validation, du routage ou de la relecture, c'est un second système que vous n'avez pas encore budgété.
À savoir également
Quatre projets figurent dans la plupart des listes de ce type mais n'apparaissent pas dans celle-ci, pour des raisons qui méritent d'être précisées.
Surya est réellement performant sur les tableaux et la notation mathématique, et mérite d'être testé pour les documents scientifiques. Les termes de sa licence ont changé et l'usage commercial est désormais conditionné : vérifiez le dépôt avant de vous appuyer dessus.
Kraken reste excellent pour les manuscrits historiques et les écritures non standard. C'est une spécialité de recherche plutôt qu'un choix d'OCR généraliste, ce qui explique sa place ici plutôt que dans la liste principale.
OCRmyPDF est une surcouche, pas un moteur. Il ajoute une couche de texte aux PDF scannés en s'appuyant sur Tesseract en arrière-plan. Réellement utile pour rendre des archives consultables, mais il hérite des limites de Tesseract au lieu de les résoudre.
OCRopus et CuneiForm sont, dans les faits, à l'abandon. CuneiForm n'a connu aucune nouvelle version depuis plus de dix ans. Les deux continuent pourtant d'apparaître dans des articles comparatifs, y compris dans de précédentes versions de celui-ci.
Deux autres entrées ont été retirées de cet article car il ne s'agit pas de solutions open source. Mistral OCR est une API payante. OCR.Space est un service hébergé freemium. Ce sont tous deux des produits tout à fait valables, mais fréquemment mal classés , y compris par nous auparavant. Leur place est dans un comparatif de services OCR hébergés, pas dans celui-ci.
Comment choisir un OCR open source en 2026
Passez en revue les contraintes dans l'ordre : chacune élimine davantage de candidats que ne le fait le benchmark.
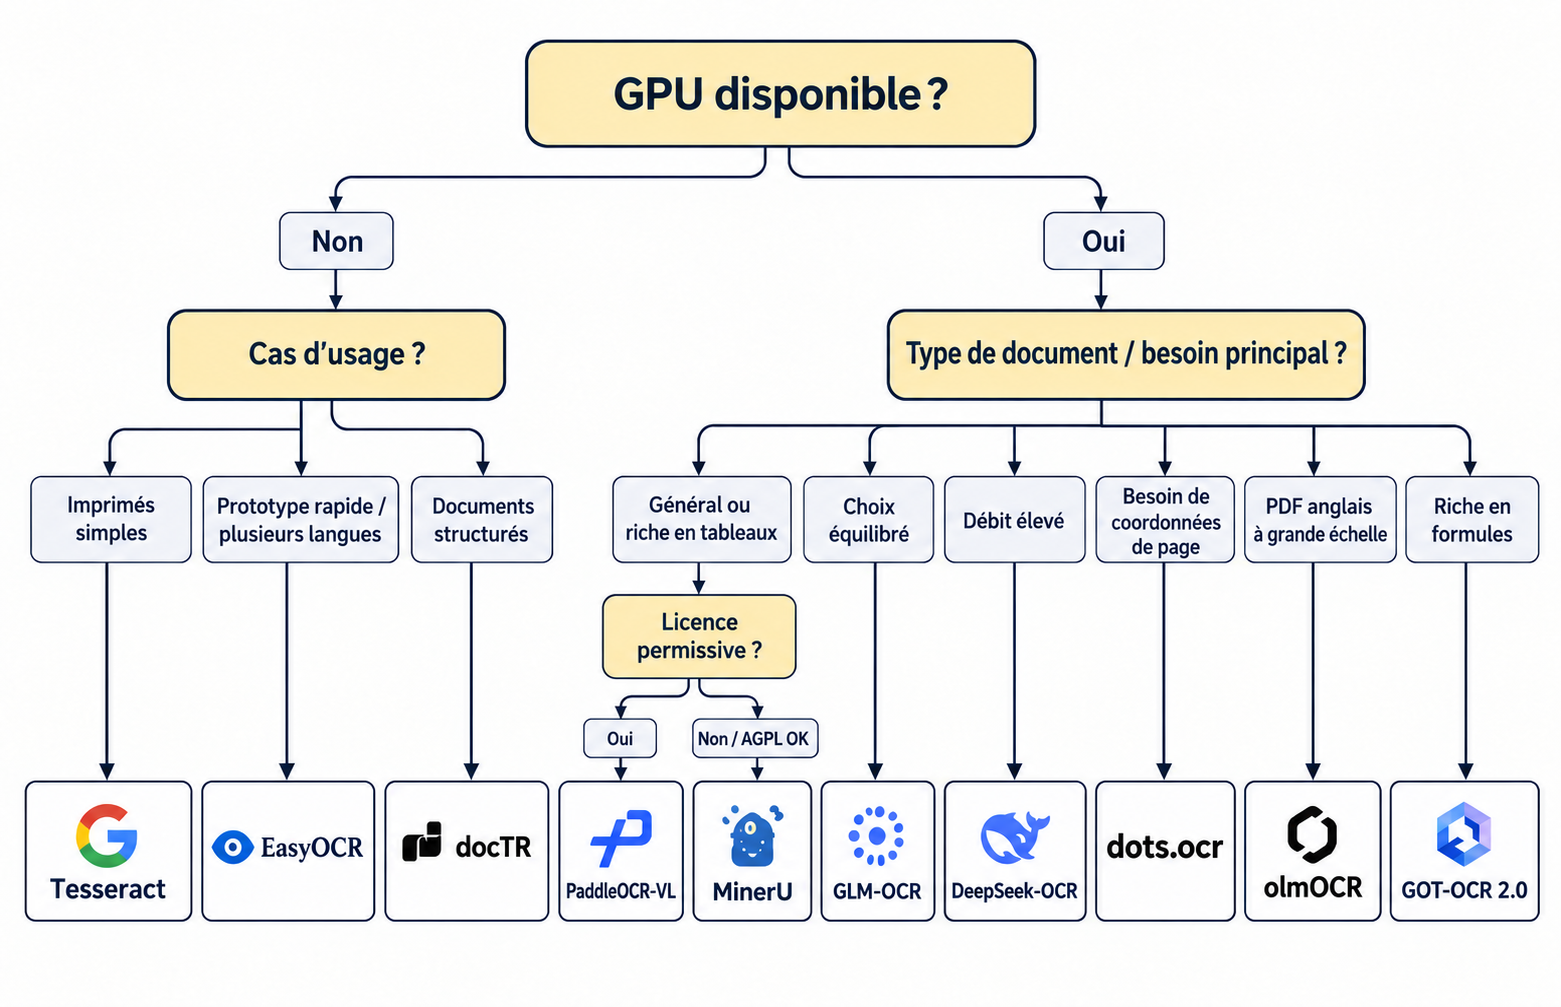
Commencez par le matériel. Pas de GPU signifie Tesseract, EasyOCR ou docTR, et le reste de cet article devient une lecture de fond. Un GPU ouvre l'ensemble de la liste.
Vient ensuite le type de documents. Des documents financiers riches en tableaux orientent vers PaddleOCR-VL ou MinerU. Du texte imprimé propre fonctionne avec n'importe quelle solution. L'écriture manuscrite impose un modèle vision-langage et des attentes réalistes. Les flux entrants au format hétérogène nécessitent généralement une classification automatique des documents avant l'OCR plutôt qu'après.
Vient ensuite la licence, à vérifier sur le dépôt plutôt qu'en faisant confiance à un article , celui-ci compris. L'AGPL-3.0 en particulier piège les équipes qui prévoient d'exposer le modèle via un service interne.
Testez ensuite vos propres documents. Cinquante fichiers, y compris vos pires scans, passés sur deux ou trois candidats, vous en apprendront davantage que l'intégralité du tableau OmniDocBench. Le corpus du benchmark n'est pas votre corpus.
Enfin, chiffrez l'ingénierie plutôt que la licence. Le modèle est gratuit. Les heures de GPU, le réglage, le réentraînement à mesure que votre mix documentaire évolue, et la couche de validation dont vous aurez tôt ou tard besoin, eux, ne le sont pas. Comparez honnêtement ce coût à celui d'une API OCR hébergée avant de partir du principe que l'auto-hébergement revient moins cher. Pour certaines équipes, c'est clairement le cas. Pour d'autres, la gratuité de la licence s'avère être la plus petite ligne du budget.
FAQs
Pourquoi Mistral OCR et OCR.Space ne figurent-ils pas dans cette liste ?
Parce que ni l'un ni l'autre ne sont open source. Mistral OCR est une API payante et OCR.Space est un service hébergé freemium. Tous deux sont fréquemment cités comme des outils open source, y compris dans une version antérieure de cet article, mais il s'agit de produits commerciaux. Ils peuvent constituer le bon choix pour votre projet, mais ils relèvent d'un autre comparatif.
Sources
- OmniDocBench v1.5 and v1.6 leaderboard results, as published by the PaddleOCR-VL team on Hugging Face.
- olmOCR-Bench results for dots.ocr, DeepSeek-OCR, PaddleOCR-VL and olmOCR 2.
- Official GitHub and Hugging Face repositories for each of the ten engines, accessed September 2026.
- Koncile, Tesseract OCR: is it still the best open-source OCR in 2026. Internal benchmark on 14 invoices.
- Licence files as published on each project repository, September 2026.