Qu’est-ce que le NLP ?
Le Natural Langage Processing NLP (ou traitement du langage naturel en français) est un domaine de l’intelligence artificielle et du machine learning qui permet, via des algorithmes linguistiques et statistiques, de comprendre le langage naturel humain.
Son objectif principal est donc de permettre aux machines de comprendre, d’interpréter et de produire la langue humaine de manière à la fois pertinente et utile.
La majorité des utilisateurs ont déjà interagi avec le NLP sans en avoir vraiment conscience.
Cette technologie est en effet au cœur des assistants virtuels tels qu’Oracle Digital Assistant (ODA), Siri ou Alexa. Elle leur permet de comprendre les requêtes des utilisateurs et d’y répondre dans un langage naturel. De la même manière, certaines applications de messagerie s’appuient sur le NLP pour analyser le contenu d’un message et proposer automatiquement une réponse adaptée.
NLP vs NLU vs NLG : différences clés
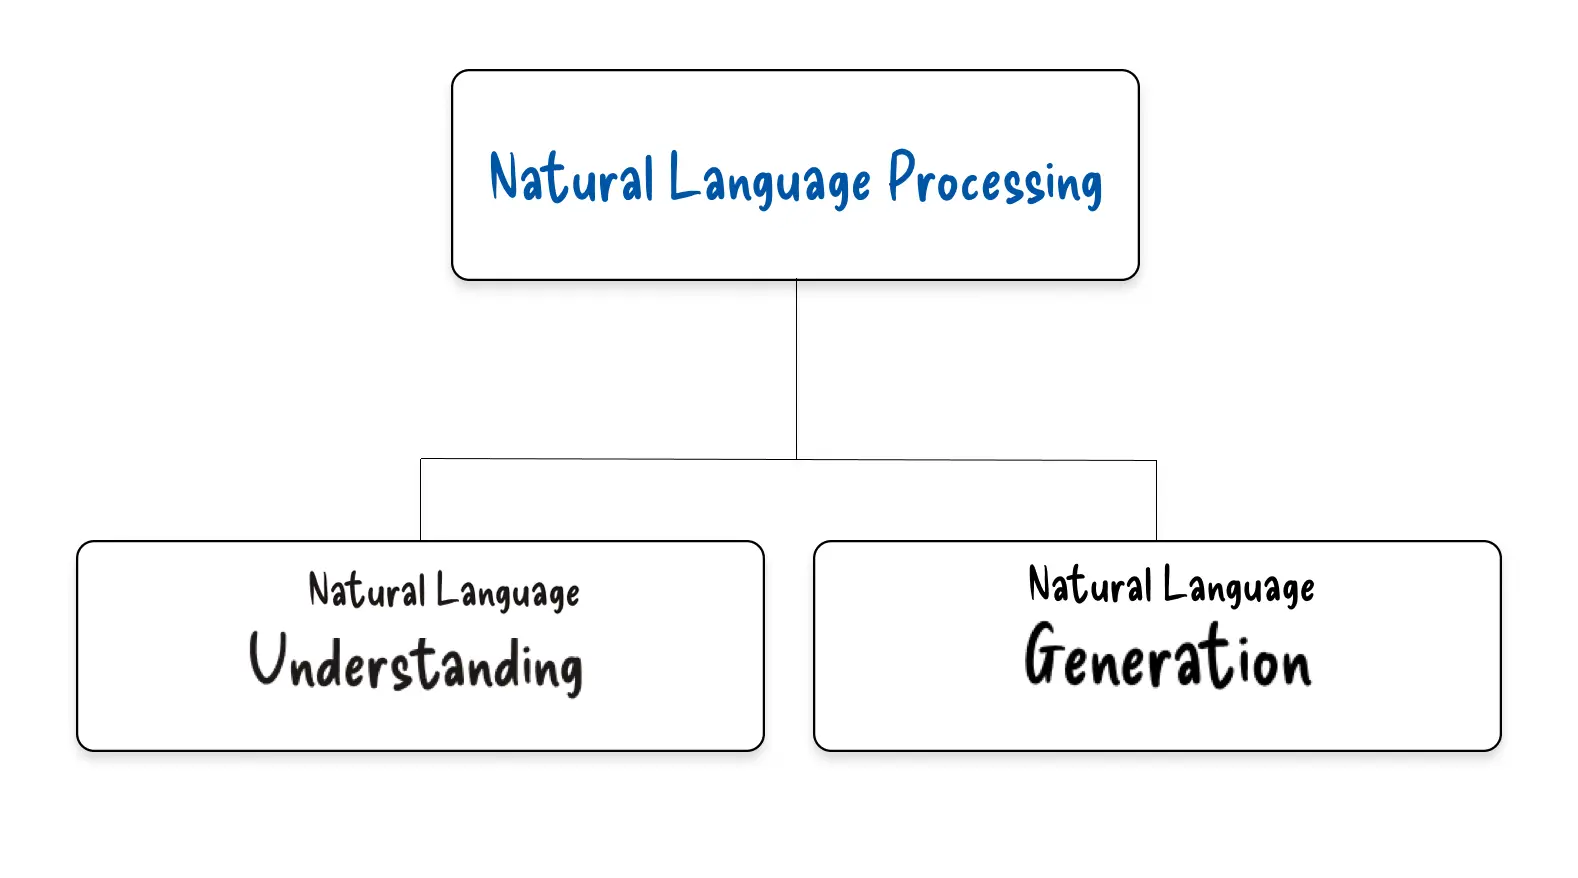
Dans l’univers du traitement automatique du langage, plusieurs termes voisins coexistent et prêtent parfois à confusion. Le NLP (Natural Language Processing), le NLU (Natural Language Understanding) et le NLG (Natural Language Generation) désignent en réalité des approches complémentaires autour du langage naturel.
- NLU (Natural Language Understanding) correspond à la capacité des machines à analyser et comprendre la structure et le sens d’une phrase exprimée par un humain. Il s’agit de l’aspect « compréhension », permettant d’interagir avec les ordinateurs en utilisant des phrases naturelles.
- NLG (Natural Language Generation) se concentre sur la production de texte à partir de données. On parle aussi de « language out » : l’ordinateur génère une description verbale, un résumé ou une explication en langage clair, souvent à l’aide de modèles linguistiques ou de règles (parfois appelées grammaire des graphiques).
- NLP (Natural Language Processing), plus large, englobe à la fois la compréhension et la génération du langage. C’est le domaine d’ingénierie qui vise à construire des systèmes capables de traiter, analyser, produire et manipuler le langage humain.
En parallèle, la linguistique informatique (Computational Linguistics , CL) constitue le champ scientifique qui étudie les aspects théoriques et informatiques du langage humain, tandis que le NLP met l’accent sur l’application concrète et l’ingénierie de solutions exploitables.
Les principales applications du NLP
Le traitement automatique du langage naturel couvre un large éventail d’usages et façonne de plus en plus nos pratiques quotidiennes.
Voici un aperçu de ses usages les plus marquants :
Les 6 étapes clés du traitement du langage naturel (NLP)
Le traitement automatique du langage naturel (NLP) suit un pipeline structuré, combinant des techniques linguistiques, statistiques et d’apprentissage automatique.Voici les grandes étapes qui permettent de transformer un texte brut en informations exploitables.
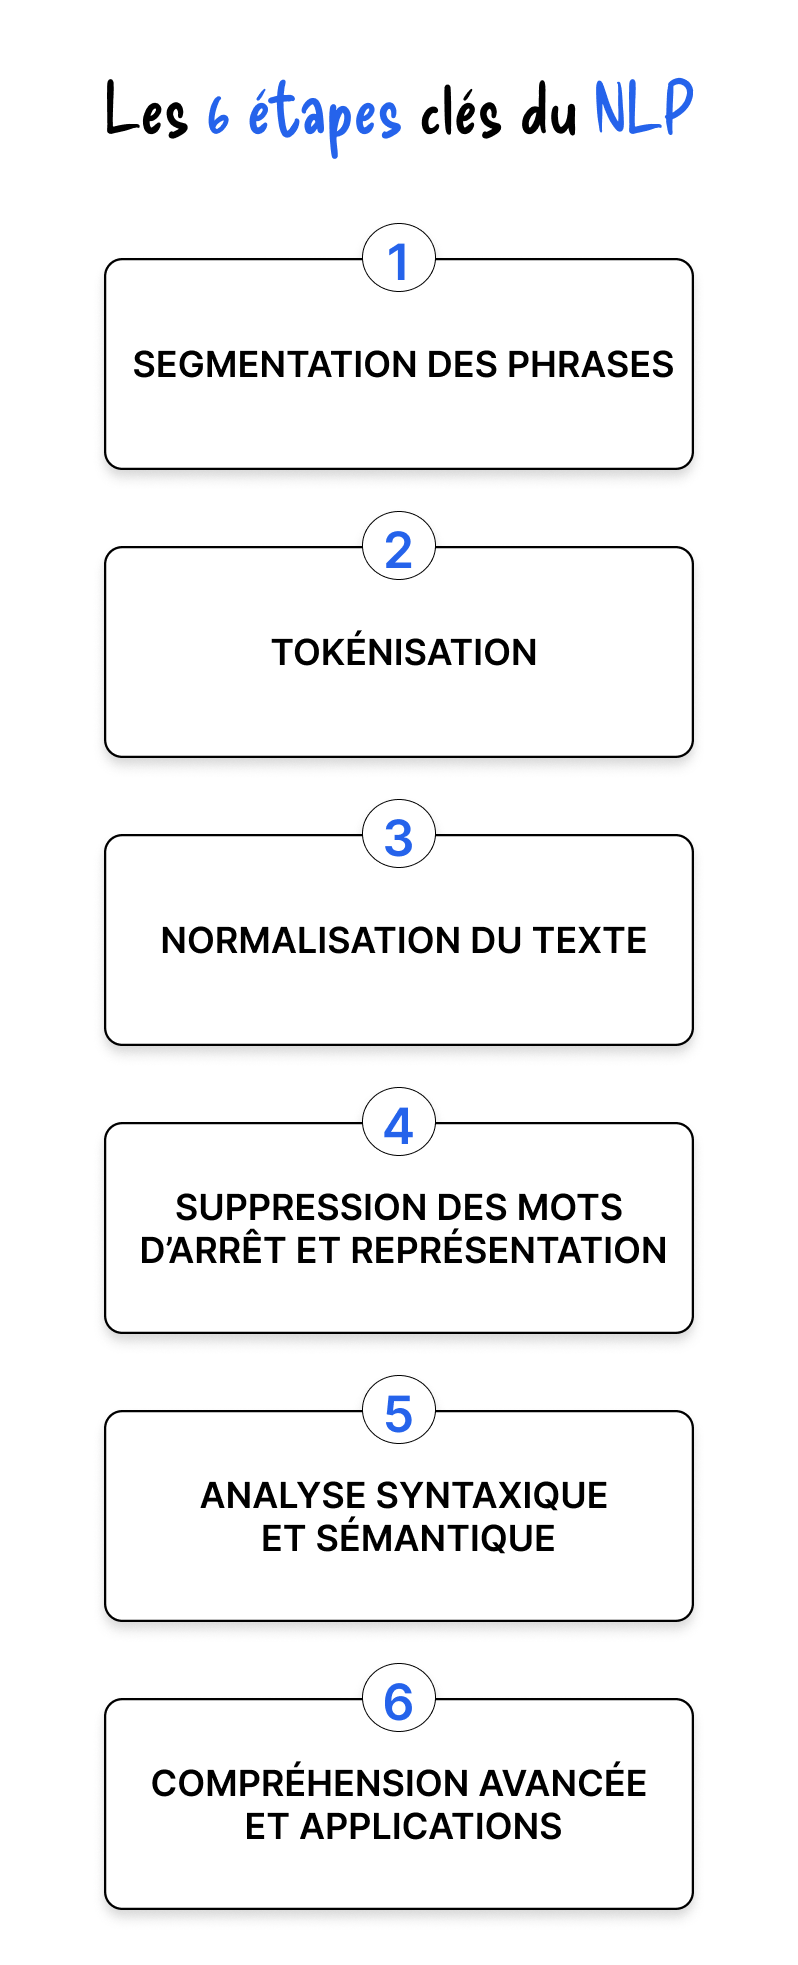
1. Segmentation des phrases
Le processus commence par la segmentation, qui découpe un texte en phrases distinctes. Un algorithme identifie les signes de ponctuation (points, exclamations, interrogations) afin d’isoler des unités de sens complètes.Tout commence par la segmentation, qui consiste à découper un texte en phrases distinctes.
2. Tokénisation
La tokénisation divise chaque phrase en unités élémentaires appelées tokens : mots, sous-mots, chiffres ou ponctuation.
Cette étape prépare le terrain pour l’analyse grammaticale et sémantique.
3. Normalisation du texte
Le texte est ensuite simplifié pour réduire la variabilité linguistique.
Deux techniques principales sont utilisées :
- La racinisation (stemming) : coupe les suffixes pour garder uniquement la racine du mot (“mangé” → “mang”).
- La lemmatisation : ramène le mot à sa forme canonique correcte (“mangé” → “manger”).
Cette étape garantit une meilleure cohérence dans l’analyse des données textuelles.
4. Suppression des mots d’arrêt et représentation
Certains mots fréquents, dits stop words (“et”, “de”, “le”), sont supprimés car ils apportent peu d’information.
Ensuite, le texte est converti en données numériques exploitables :
- via un modèle sac de mots (bag-of-words) ou un TF-IDF,
- ou via des embeddings (Word2Vec, BERT) qui capturent le sens et le contexte des mots.
5. Analyse syntaxique et sémantique
À cette étape, le système cherche à comprendre la structure des phrases :
- PoS tagging : attribuer à chaque mot sa fonction grammaticale (nom, verbe, adjectif…).
- Parsing syntaxique : identifier les relations sujet,verbe,complément.
- NER (Named Entity Recognition) : extraire des entités comme des personnes, des lieux ou des organisations.
6. Compréhension avancée et applications
Enfin, le texte peut être exploité dans des applications concrètes :
- analyse de sentiment (positif, négatif, neutre),
- résumé automatique ou traduction,
- résolution de coréférence (“Jean est arrivé. Il était fatigué” → “Il” = “Jean”).
C’est à ce stade que le NLP devient directement utile dans des cas métiers : chatbots, moteurs de recherche, extraction documentaire (OCR + NLP), assistants virtuels, etc.
Les défis du NLP
Malgré ses avancées spectaculaires, cette discipline se heurte encore à plusieurs obstacles techniques et linguistiques qui limitent son déploiement à grande échelle.
Quand l’OCR rencontre le NLP
La reconnaissance optique de caractères (OCR) est la technologie qui permet de transformer une image contenant du texte imprimé ou manuscrit (facture scannée, contrat signé, note de frais, formulaire, etc.) en texte numérique exploitable.
Cette étape est essentielle pour convertir des documents papier ou des fichiers image en données structurées, prêtes à être traitées par un ordinateur.
Là où l’OCR se limite à capturer fidèlement le texte, le NLP ajoute une couche d’intelligence et de compréhension contextuelle. Il est capable de classer, contextualiser et extraire les informations pertinentes, transformant ainsi un texte brut en données immédiatement exploitables par les systèmes métiers.
En résumé : l’OCR numérise, le NLP comprend.
Ce que permet l’intégration OCR + NLP
L’association de l’OCR et du NLP présente plusieurs atouts pour les entreprises :
FAQ
Quels sont les types d’algorithmes les plus utilisés en NLP ?
On utilise encore des règles et expressions régulières pour des motifs simples, mais la norme actuelle repose sur le machine learning et surtout les réseaux de neurones Transformers préentraînés (BERT, GPT, etc.). Les approches hybrides qui combinent recherche et génération (RAG) se généralisent pour gagner en précision et en traçabilité.
Quelles données sont nécessaires pour entraîner un modèle NLP ?
Un corpus représentatif du domaine, propre et varié, avec des annotations de qualité alignées sur la tâche. La diversité compte plus que le volume brut. En contexte sensible, il faut prévoir anonymisation et gouvernance des données.
Quels secteurs bénéficient le plus du NLP aujourd’hui ?
Service client, finance et conformité, juridique et assurance, santé, e-commerce et marketing, ainsi que RH. Le point commun est l’automatisation de la lecture, la compréhension et la priorisation de grands volumes de texte.
Le NLP peut-il comprendre l’ironie ou le sarcasme ?
Partiellement. Les modèles détectent certains indices de contexte ou de tonalité, mais la performance reste inférieure à des tâches factuelles. Pour des décisions sensibles, mieux vaut prévoir une validation humaine ou des règles de prudence.
Le NLP est-il compatible avec des documents manuscrits ?
Oui, si le manuscrit est d’abord converti en texte via HCR ou ICR, qui sont des extensions de l’OCR. La qualité du résultat dépend alors du prétraitement du document et des paramètres de confiance. Un contrôle humain ciblé peut sécuriser les cas ambigus.
Comment évaluer la qualité d’un modèle NLP ?
Selon la tâche : précision, rappel et F1 pour classification et NER, BLEU/COMET pour la traduction, ROUGE/BERTScore pour le résumé, Exact Match et F1 pour la question,réponse. En production, on suit aussi le taux de traitement direct, l’escalade vers l’humain, la latence et la dérive des données. Une revue humaine régulière reste indispensable.
Le NLP fonctionne-t-il avec les manuscrits ?
Oui, via HCR/ICR (extensions de l’OCR). La qualité dépend du scan et du prétraitement.